French

French

« JITRO » de Google et la logique clinique d’une IA orientée par objectifs : quand les systèmes cessent d’attendre des prompts

Lors des réunions de recherche clinique, une tension récurrente devient difficile à ignorer : nous souhaitons une automatisation qui réduise les erreurs et libère de l’attention pour le jugement, tout en redoutant de perdre en visibilité sur la manière dont les décisions sont produites. C’est dans ce contexte que circulent des publications et commentaires en ligne sur « JITRO » de Google. L’idée centrale n’est pas une simple évolution des copilotes existants, mais l’émergence d’une catégorie différente d’IA, qui n’attend plus d’instructions ponctuelles parce qu’elle est structurée autour d’objectifs plutôt que d’échanges conversationnels. Dans ces descriptions, JITRO est présenté comme un agent de codage autonome développé par Google, constituant une étape de nouvelle génération au-delà de Jules. L’interaction proposée s’apparente davantage à une délégation : vous définissez un résultat, et le système détermine le chemin, les étapes intermédiaires et le plan d’exécution. Autrement dit, il s’agit d’un passage d’une IA outil à une IA auto-pilotée, où le rôle humain évolue d’opérateur à superviseur plutôt que rédacteur principal. Il est utile d’ancrer cela dans les éléments officiellement documentés. Jules est présenté comme un agent de codage asynchrone capable de travailler sur un dépôt dans un environnement cloud dédié, de proposer un plan, d’implémenter des modifications, puis de dépendre d’une validation humaine avant intégration. Ce choix de conception n’est pas anecdotique : il incarne un principe de sécurité déjà familier en formation Clinique, l’autonomie peut être utile, mais elle doit rester encadrée par des productions vérifiables et une validation responsable. Pour les cliniciens et les chercheurs en santé, un « agent de codage autonome » devient pertinent dès lors que l’on reconnaît que notre base de connaissances est médiée par des logiciels. Les essais et évaluations de services reposent sur des scripts de prétraitement, du code de cotation, des tableaux de bord d’événements indésirables et des analyses versionnées susceptibles de dériver sans être détectées. Un système capable d’identifier les modifications nécessaires dans un code pour améliorer la couverture de tests ou réduire les erreurs peut renforcer la fiabilité, mais il déplace également le risque vers l’infrastructure qui rend nos méthodes opérantes. La différence avec les outils basés sur des prompts ne tient pas seulement à la vitesse, mais à une redistribution de la décomposition des tâches. Dans un flux de travail guidé par prompts, l’humain découpe les étapes et oriente en continu. Dans un flux orienté par objectifs, le système effectue lui-même cette décomposition, et vous évaluez ensuite le plan, les modifications et les preuves que l’objectif est atteint. Cliniquement, cela s’apparente à la différence entre guider un stagiaire minute par minute et superviser un plan de prise en charge autonome. La recherche sur les facteurs humains aide à comprendre pourquoi cette transition peut sembler trompeusement « facile ». À mesure que les systèmes passent de l’assistance à l’action, le rôle humain devient celui de la surveillance, une activité cognitivement exigeante et vulnérable à la surconfiance sous pression temporelle. Dans l’aide à la décision clinique, le biais d’automatisation correspond à une diminution de la détection d’erreurs en présence de suggestions automatisées, en particulier lorsque les flux de travail valorisent la rapidité. Un agent d’ingénierie persistant peut créer une vulnérabilité analogue : plus il paraît compétent, moins nous interrogeons les cas limites. C’est pourquoi l’accent mis sur les points de validation n’est pas un simple détail technique. L’enjeu pratique est de savoir si ces points offrent une véritable inspectabilité, plans clairs, preuves de test, correspondance intelligible entre objectifs et modifications de code, plutôt qu’un simple feu vert final. Sans justifications lisibles et validation significative, le « human-in-the-loop » risque de devenir performatif, en particulier dans des bases de code volumineuses où personne ne peut tout examiner de manière exhaustive. Plusieurs incertitudes doivent être explicitement reconnues. Le terme « JITRO » apparaît davantage dans des commentaires informels que dans une documentation technique primaire, ce qui implique de considérer ses capacités comme provisoires. Néanmoins, en tant que concept, il cristallise une transition en cours : ne plus considérer l’IA comme quelque chose que l’on sollicite par prompts, mais comme un système à qui l’on donne une direction. Ce changement de perspective peut rendre les outils existants plus puissants, tout en transformant la définition des objectifs en un acte méthodologique à part entière. Sur le plan éthique, les agents orientés par objectifs accentuent des obligations déjà bien établies en contexte clinique et de recherche. La responsabilité demeure du côté de l’équipe humaine, même lorsque le système est l’auteur proximal des modifications ; la transparence doit être conçue de manière à rendre les décisions reconstructibles ; et l’intégrité des données repose sur des dispositifs de gouvernance, de test et d’audit capables de détecter les dérives. Les cadres de gestion du risque insistent sur la responsabilité et le suivi continu, et ces exigences deviennent plus importantes, et non moins, à mesure que l’autonomie augmente. L’attitude la plus constructive n’est ni le rejet ni l’enthousiasme naïf, mais une curiosité disciplinée : si les agents orientés par objectifs deviennent des coéquipiers en ingénierie, nous devons développer une science de la supervision à la hauteur. Cela implique d’étudier quels dispositifs de validation réduisent réellement les erreurs, comment quantifier la dérive dans des pipelines modifiés par des agents, et comment préserver l’interprétabilité lorsque les plans sont générés par des systèmes optimisés pour le débit. La transition est peut-être en cours, mais sa valeur clinique dépendra de notre capacité à concilier automatisation orientée vers les résultats, rigueur méthodologique et responsabilité.
French

Un nouveau risque cyber dans la salle de thérapie : pourquoi Project Glasswing change l’équation de la confiance

La cybersécurité n’est plus un problème technique de niche. C’est une condition de la vie moderne : banque, éducation, services publics et santé reposent sur des couches fragiles de logiciels que nous voyons rarement. La plupart des gens ne remarquent cette fragilité que lorsque quelque chose déraille : une panne, une violation, un compte bloqué, un système soudainement indigne de confiance. Le risque est large, mais les conséquences ne sont pas également réparties. En santé, cette inégalité se fait sentir rapidement. Lorsque les systèmes numériques défaillent, les soins ne se mettent pas poliment en pause le temps du rétablissement. Les personnes se présentent toujours en détresse, en insécurité ou en pleine crise, et les cliniciens doivent continuer de décider avec des informations incomplètes. L’« incident technique » devient humain, souvent en quelques minutes. C’est pourquoi les thérapeutes doivent s’y intéresser, même si la conversation semble éloignée du quotidien clinique. En thérapie, la cybersécurité ne s’annonce que rarement comme telle. Elle se manifeste par une séance annulée inopinément parce que la planification est en panne, un lien de téléconsultation qui échoue à la dernière minute, ou une clinique soudain incapable d’accéder aux notes. Elle se manifeste aussi lorsqu’un client demande, calmement mais directement, si ses messages sont réellement privés. Dans ce contexte, l’annonce d’Anthropic du 7 avril 2026 sur Project Glasswing est plus qu’une actualité technologique. L’entreprise y décrit un modèle non publié, Claude Mythos Preview, et insiste sur le fait qu’il ne sera pas rendu disponible au grand public. Il est plutôt acheminé via un programme restreint, présenté comme à usage défensif. Lorsqu’un laboratoire d’IA décide qu’un modèle est trop capable pour être diffusé, c’est un signal sur l’orientation du paysage des menaces. La raison clé avancée pour ce verrouillage est simple et troublante : Anthropic présente Mythos Preview comme étant capable de trouver des vulnérabilités graves avec très peu de pilotage humain. En termes clairs, il repérerait des points faibles logiciels plus vite et de façon plus autonome que les systèmes antérieurs. Même si l’intention est défensive, la capacité en elle‑même importe, car les capacités tendent à se diffuser et les attaquants s’adaptent. Les exemples d’Anthropic sont de ceux qui mettent mal à l’aise, à juste titre, les non‑techniciens. Ils mettent en lumière des faiblesses dans des logiciels fondamentaux très utilisés et décrivent des cas où des problèmes ont persisté des années, voire des décennies, sans être détectés. Voilà la vérité inconfortable de l’infrastructure numérique : beaucoup de systèmes que nous pensons stables sont assemblés à partir de bases de code anciennes, à maintenance inégale et à la complexité cachée. Si cela paraît encore abstrait, ramenons‑le aux outils que nous utilisons effectivement. Les plateformes de téléconsultation reposent sur des navigateurs, des systèmes d’exploitation, des serveurs et des bibliothèques tierces. Les systèmes d’agenda et les portails patients dépendent d’intégrations et d’API qui peuvent multiplier silencieusement les risques. Une vulnérabilité « quelque part en amont » peut se traduire par une indisponibilité, une exposition de données ou une interruption de service au point de contact entre le client et le soin. Il existe aussi une question structurelle importante pour la santé : qui accède aux moyens de protection les plus puissants, et quand ? Restreindre un modèle très performant peut réduire les mésusages immédiats, mais concentre aussi le pouvoir et l’expertise entre quelques organisations. Les petites cliniques et éditeurs se retrouvent dépendants de calendriers de sécurité, de priorités et de décisions de divulgation qu’ils ne voient ni n’influencent aisément. Cet écart, entre attentes éthiques et réalités techniques, peut devenir un problème de confiance. Concrètement, cela nous pousse vers une vision plus explicite et systémique du risque clinique. Nous ne pouvons pas corriger des systèmes d’exploitation, mais nous pouvons intégrer la maturité cybersécurité à la qualité des soins. Cela signifie poser de meilleures questions à l’achat, exiger des engagements clairs de réponse aux incidents de la part des fournisseurs, et maintenir des protocoles de continuité en mode dégradé. Cela signifie aussi réduire les « outils fantômes » et les modules IA non gérés qui élargissent la surface d’attaque sans supervision. Éthiquement, l’enjeu n’est pas d’alimenter la panique, mais d’exiger une confiance défendable. En contexte clinique, « digne de confiance » devrait signifier qu’il existe des traces décisionnelles explicables : quel système a été utilisé, quelles données ont circulé, quelles protections étaient en place, quelle journalisation et quel audit existaient, et comment les erreurs ou incidents seront corrigés et divulgués. Les clients ne devraient pas avoir à s’en remettre à une infrastructure invisible et « espérer le meilleur » ; ils méritent des systèmes de soin conçus pour échouer sans nuire. Project Glasswing préfigure une nouvelle phase : l’IA ne transforme pas seulement les outils cliniques, elle modifie aussi l’environnement de sécurité dans lequel ces outils s’inscrivent. La confiance des patients dépend de la confidentialité, de l’intégrité et de la disponibilité, des propriétés qui reposent sur une infrastructure désormais mise à l’épreuve par des systèmes de plus en plus autonomes. Pour les thérapeutes, la tâche est de préserver le cadre clinique à mesure que le cadre technique s’accélère : protéger la continuité, protéger la vie privée et plaider pour des systèmes que nous pouvons réellement assumer.

French

Quand le modèle reste sur votre appareil : Gemma 4, « gratuit pour toujours » et ce que la confidentialité signifie réellement

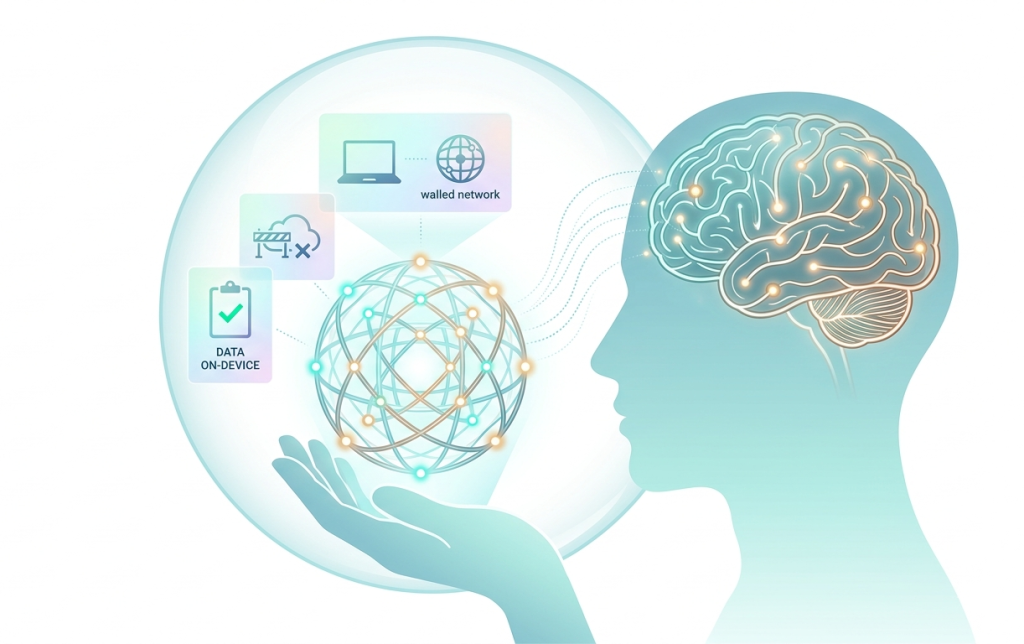
En clinique, le point de friction n’est presque jamais la curiosité pour l’IA ; c’est la gouvernance. Un supervisé souhaite de l’aide pour réécrire un rapport scolaire sensible, résumer une évaluation en ergothérapie ou rédiger un formulaire de consentement en arabe simplifié, puis pose la question que nous connaissons tous : « Puis-je coller le texte réel ? » L’inconfort éthique tient au fait que la plupart des systèmes conversationnels sont, par conception, médiés par le cloud, et notre réponse devient alors un cours de gestion des risques plutôt qu’un appui cliniquement utile. C’est pourquoi l’affirmation « Imaginez ChatGPT, mais installé directement sur votre appareil… privé, hors ligne et gratuit » se diffuse si rapidement. Elle évoque la réconciliation promise entre capacité et confidentialité. Mais les slogans ne sont pas des garde-fous, et « l’énergie de PDG » ne constitue pas un cadre de gouvernance clinique. Même lorsqu’un outil provient d’une grande entreprise, la marque ne remplace pas l’évaluation des flux de travail, de l’auditabilité et des modes de défaillance. Ce que cela traduit plus précisément, c’est l’essor d’un écosystème de modèles « local capable », dont Gemma 4, téléchargeables et exécutables dans des environnements contrôlés. La promesse est simple : poser des questions, générer du texte, structurer la documentation et, dans certaines configurations, traiter aussi des tâches liées à l’image, avec un calcul effectué sur votre propre appareil. Ce détail — l’endroit où s’exécute le modèle — n’est pas anecdotique : il est au cœur de la confidentialité. La question du « prix » est déterminante pour les thérapeutes, car elle modifie les dynamiques d’adoption. Si un modèle est « gratuit » à télécharger et à exécuter, la contrainte se déplace vers les exigences matérielles et le temps de configuration. Vous « payez » autrement : batterie, chauffe, stockage, maintenance et dépannage. Mais le changement psychologique est majeur : la technologie devient suffisamment accessible pour s’intégrer dans des pratiques réelles, et non plus seulement comme un outil expérimental. La comparaison est donc pertinente, car elle touche au cœur du flux de travail : vous choisissez une IA, mais aussi un circuit de données. Gemma 4 est une option locale, mais pas la seule. De nombreux utilisateurs exécutent également des modèles de type DeepSeek, tandis que d’autres optent pour Llama, Mistral ou Qwen selon leur matériel et leurs contraintes de licence. En résumé : les modèles locaux peuvent soutenir une confidentialité plus stricte en gardant les données en interne, tandis que les modèles cloud (ChatGPT, Claude, Gemini) offrent davantage de commodité et d’évolutivité, mais exigent des règles plus rigoureuses. La formule « Google ne voit rien » n’est donc vraie que sous une condition précise : une exécution réellement locale. Le « local » n’est pas une perception, mais une implémentation : exécution hors ligne, absence de téléversements, paramètres vérifiables. Toute utilisation via navigateur ou application web doit être considérée comme du cloud. Cliniquement, l’intérêt majeur de l’IA locale n’est pas la nouveauté, mais l’élargissement des tâches réalisables sans exposition de données sensibles : rédaction de courriers, psychoéducation, adaptation de supports, création de canevas de séance. Cela réduit la charge administrative tout en respectant davantage l’esprit de la confidentialité. Cependant, une question essentielle demeure : cela améliore-t-il réellement le raisonnement clinique ? Le risque est qu’une production fluide donne l’illusion d’une validité clinique. L’IA doit rester un outil de structuration et non un substitut au jugement clinique. L’idée de « sans limites » doit également être nuancée. Les modèles locaux ne sont pas limités par un abonnement, mais restent contraints par le matériel. Et surtout, « hors ligne » ne signifie pas « fiable » : biais et hallucinations persistent. Sur le plan éthique, l’IA locale concentre la responsabilité. Utiliser des données identifiables implique de maîtriser la sécurité de l’appareil, la journalisation, la provenance du modèle et la traçabilité de l’usage. La transparence devient une pratique : documenter quand et comment l’IA est utilisée. Ce qui est cliniquement intéressant, ce n’est pas l’illusion d’une « IA privée parfaite », mais la possibilité de concevoir des usages hybrides et nuancés : modèles locaux pour les contenus sensibles, systèmes cloud pour les tâches documentaires sous gouvernance.

French

Quand les données de santé deviennent un interlocuteur : les nouvelles intégrations de Perplexity, vues depuis la salle de thérapie

En thérapie, les « données de santé » arrivent rarement sous la forme d’un récit clair, et la dernière mise à jour santé de Perplexity s’inscrit précisément dans cette réalité. L’annonce met en avant de nouvelles intégrations permettant de rassembler des informations personnelles de santé, de les organiser dans des tableaux de bord, puis de les utiliser pour produire des synthèses et formuler des questions plus claires avant les consultations médicales. Depuis notre place de thérapeutes, une question humaine surgit immédiatement : qu’est-ce qui change lorsqu’une personne peut regrouper ses signaux de santé en un seul endroit et réellement en parler, au lieu de les traquer à travers une multitude d’applications ? Du point de vue thérapeutique, le bénéfice idéal est simple et concret : la mise en structure. Beaucoup de clients ont du mal à résumer ce qu’ils vivent d’une manière réellement exploitable par un clinicien : quand cela a commencé, ce qui le déclenche, ce qui l’améliore ou l’aggrave, ce qui a déjà été essayé, ce qui a changé, et comment cela affecte le sommeil, le travail, l’appétit, l’humeur ou les relations. Si un outil peut aider à élaborer un résumé préconsultation à partir du désordre de la vie réelle, il peut alléger la charge cognitive, réduire la honte « je n’arrive pas à bien l’expliquer » et permettre d’aborder un rendez-vous avec des questions plus claires et moins d’omissions. Mais les limites et les difficultés sont bien réelles, et ne tiennent pas seulement au paramétrage. Le principal enjeu clinique que nous observons est qu’un tableau de bord unifié peut insidieusement devenir un « moniteur de menace ». Chez les clients sujets à l’anxiété de santé, à la panique, aux conduites de réassurance de type TOC, à l’hypervigilance corporelle liée au traumatisme ou au stress chronique, davantage de suivi ne signifie pas toujours davantage de clarté. Cela peut au contraire multiplier les vérifications, amplifier des fluctuations normales et maintenir le système nerveux en état d’alerte, surtout lorsque les chiffres sont vécus comme des verdicts plutôt que comme des éléments de contexte. Un autre risque est celui d’une fausse clarté. Les objets connectés produisent des données bruitées, les bilans biologiques ne donnent que des instantanés, et les dossiers médicaux peuvent être incomplets ou incohérents. Lorsqu’un résumé généré par une IA adopte un ton trop assuré, il peut orienter vers des conclusions qui ne sont pas réellement étayées, tantôt en alimentant la catastrophisation, tantôt en minimisant quelque chose d’important. En thérapie, nous nous soucions moins de savoir si l’outil est « intelligent » que de sa capacité à communiquer l’incertitude avec honnêteté, et de la capacité de la personne qui l’utilise à tolérer cette incertitude sans s’emballer. S’ajoute à cela une difficulté plus élémentaire : l’accès et l’usage. Intégrer des comptes, gérer les autorisations et relier des dossiers peut être déroutant, et ceux qui ont le plus besoin de soutien sont souvent les moins équipés pour résoudre seuls une configuration complexe, surtout lorsqu’ils sont déjà épuisés, douloureux ou submergés. Si l’outil devient une tâche supplémentaire dans laquelle ils ont le sentiment d’« échouer », il peut renforcer précisément le sentiment d’impuissance que nous cherchons à atténuer. La confidentialité constitue un défi plus discret, qui apparaît souvent plus tard en séance. Les personnes ne téléversent pas seulement des « données de santé » ; elles téléversent aussi de la peur, de la vulnérabilité, et tout un contexte qui déborde sur la santé mentale, les relations, l’usage de substances, la santé sexuelle ou l’histoire traumatique. En situation de détresse, on est facilement tenté d’échanger de la confidentialité contre de la réassurance. Une part de notre travail consiste à ralentir ce moment, non pour juger ce choix, mais pour aider la personne à le faire de manière éclairée. Si nous devions intégrer ce type d’outil en thérapie, nous le traiterions comme un support collaboratif, non comme une autorité. Nous apporterions le résumé, puis nous ferions ce que la thérapie sait faire de mieux : ralentir, confronter à la réalité, et traduire cela en prochaines étapes. Qu’est-ce qui manque ? Qu’est-ce qui relève peut-être d’une surinterprétation ? Cet outil renforce-t-il votre pouvoir d’agir, ou alimente-t-il une forme de surveillance compulsive ? Utilisés avec discernement, ces outils peuvent favoriser de meilleures conversations avec les soignants. Utilisés sans précaution, ils peuvent donner au récit une cohérence apparente tout en augmentant subrepticement l’anxiété. La différence tient rarement à la technologie seule ; elle réside dans la relation que la personne construit avec elle.

French

La « sécurité » de l’IA n’est pas la sécurité clinique : ce que la tendance de recherche implique pour notre pratique thérapeutique

Un point utile à garder à l’esprit est le suivant : de nombreux chatbots d’IA paraissent « sûrs » lors des tests parce qu’ils refusent les demandes manifestement nocives, mais peuvent malgré tout répondre de manière non sécurisée lorsque la même intention est formulée de façon indirecte. On parle souvent d’une sécurité fondée sur des mots‑clés (repérer des termes signalés) par opposition à une sensibilité à l’intention (comprendre ce que la personne cherche réellement à faire). Autrement dit, le modèle peut réussir des contrôles de sécurité en reconnaissant certains termes, tout en échouant lorsque la détresse est exprimée dans un langage plus humain et ambigu. Ce que cela signifie pour notre pratique thérapeutique est immédiat : nos clients parlent rarement un « langage du risque » clair et explicite. Ils testent le terrain. Ils minimisent. Ils recourent aux métaphores. Ils alternent les registres. Ils communiquent par le ton et l’omission. Si un outil ne « détecte » le risque que lorsque le client emploie les bons mots, il reproduit la forme d’évaluation la moins utile, celle qui récompense la performance et passe à côté de l’expérience vécue. Deuxième réalité clé : de nombreux modèles sont entraînés à être chaleureux, validants et accommodants. Cela peut sembler soutenant, mais cliniquement nous savons qu’une validation sans discernement peut se muer en renforcement. En tant que thérapeutes, nous validons l’émotion tout en examinant avec nuance et tact les distorsions, en vérifiant la réalité et en observant le fonctionnement dans le temps. Une IA peut, sans le vouloir, valider simultanément l’émotion, l’interprétation et le plan impulsif, car elle est optimisée pour être aidante et cohérente, non pour répondre à une exigence de responsabilité clinique. S’ajoute le biais de l’IA, et en thérapie nous devons partir du principe qu’il se manifeste de façons qui comptent. Les modèles peuvent répondre différemment selon le dialecte, l’anglais en seconde langue, des expressions de la douleur façonnées par la culture, ou même selon le degré d’« organisation » apparente du récit. Le client désorganisé, répétitif ou fragmenté (souvent celui qui a le plus besoin d’aide) peut recevoir une réassurance générique, tandis que le client articulé et persuasif obtient des réponses plus détaillées et plus convaincantes. Ce n’est pas seulement injuste, cela peut fausser l’évaluation du risque, l’alliance et la prise de décision. Concrètement, lorsqu’un client nous dit qu’il utilise un chatbot, nous ne le considérons plus comme un détail anecdotique : nous le traitons comme une nouvelle « un troisième interlocuteur» dans le système. Nous demandons : Quand l’utilisez‑vous, avant de dormir, après des disputes, en plein épisode de panique ? Que dit‑il le plus souvent ? Vous sentez‑vous plus calme, ou plus certain ? Réduit‑il la honte, ou vous maintient‑il dans une boucle ? Cette évaluation nous fournit des données cliniques : le rôle de l’outil (apaisement, escalade, évitement, répétition) et la relation du client avec lui (dépendance, secret, soulagement, honte). En séance, ces informations nous amènent à expliciter davantage la différence entre validation émotionnelle et contenance clinique. Nous pourrions dire : « Un chatbot peut paraître attentionné tout en manquant ce que nous suivons, les schémas de risque, les déclencheurs, les signatures de rechute, la coercition, la dissociation, les réponses traumatiques. » Ce n’est pas de l’anti‑tech ; c’est de la psychoéducation. Cela aide les clients à comprendre pourquoi « je me suis senti soutenu » n’équivaut pas à « c’était sûr pour mon système nerveux et pour mes conséquences réelles ». Cela modifie aussi notre manière d’aborder les conversations sur le risque. Parce que la sécurité de l’IA peut être guidée par des signaux, nous supposons que les clients ont pu apprendre (sans le vouloir) que certains formulations sont bloquées tandis que d’autres sont encouragées. Cela peut influencer la divulgation : les clients peuvent éviter un langage direct, ou répéter des récits qui « sonnent » plus sûrs. Concrètement, nous aménageons davantage d’espace pour une mise en mots progressive: « Si c’est difficile à dire franchement, pouvons‑nous l’encercler, quels sont les mots les plus proches que vous pouvez tolérer maintenant ? » On garde ainsi la porte ouverte sans exiger une performance. Côté praticiens, cela nous pousse à resserrer les limites et la documentation dès que l’IA touche notre flux de travail. Si nous utilisons l’IA pour des brouillons (supports, synthèses, exercices), nous la traitons comme un stagiaire : nous relisons chaque ligne, retirons tout ce qui sonne trop affirmatif et traquons les présupposés biaisés (culture, rôles de genre, attentes familiales, langage des « il faut »). Si une organisation propose des notes rédigées par IA, notre question clinique devient : où vont les données, qui peut y accéder, et que se passe‑t‑il si le modèle invente des détails ? La responsabilité clinique ne disparaît pas. Quand nous conseillons des collègues ou une clinique, nous traduisons tout cela en questions d’évaluation simples : L’outil reste‑t‑il sûr au fil de tours multiples, ou dérive‑t‑il vers un excès d’accord ? Répond‑il de manière appropriée à une détresse indirecte ? Traite‑t‑il de façon cohérente différents dialectes et expressions culturelles ? Dispose‑t‑il de modalités d’escalade claires (ressources de crise, « obtenir de l’aide humaine ») sans culpabiliser ? Si un fournisseur ne peut répondre clairement à ces points, nous supposons que l’outil est optimisé pour des démonstrations, pas pour la réalité concrète de la pratique thérapeutique. Enfin, nous considérons le biais de l’IA comme une question d’équité au sein des soins, non comme une note de bas de page technologique. Nous l’intégrons à la supervision et à la formation : nous jouons des scénarios avec des formulations indirectes, différents idiomes culturels de la détresse et des récits de relations coercitives pour voir comment les outils pourraient les mal interpréter. Et nous disons aux clients quelque chose de stabilisant : « Utilisez‑le si cela vous aide, mais ne le laissez pas devenir votre juge, votre diagnostic, ni votre plan de sécurité. » En pratique, cette position nous maintient cliniquement responsables tout en reconnaissant le monde dans lequel nos clients vivent déjà.

French

Quand la numérisation devient invisible : vers un « papier → PDF » quasi automatique

Dans le travail clinique et de recherche, la numérisation ne vise pas un « beau » PDF ; elle sert surtout à ne pas alourdir les workflows. On scanne avenants, lettres d’orientation, listes de médicaments, CRF et notes manuscrites qui font foi. Des années durant, le mobile a amélioré l’image au prix d’une chorégraphie répétitive, cadrer, appuyer, confirmer, recommencer. Dans l’expérience récente de Google Drive, l’essentiel est l’interaction : moins de tapotements, capture continue et davantage de « jugement » logiciel sur le bon moment. Le scanner de Google Drive accepte le multi‑pages depuis longtemps, mais fonctionne désormais comme un vrai canal d’acquisition in‑app, pas un outil à part. Concrètement, on ne « lance » plus une appli pour exporter, renommer, téléverser ; on « crée un document » là où l’équipe stocke déjà ses fichiers. Quand la capture devient native à la plateforme quotidienne, l’adoption progresse sans formation. La nouveauté tient à la disparition des frictions, plus qu’à l’effet « waouh ». Le quasi‑automatisme vient de la chaîne détection–stabilisation–déclenchement, qui élimine les micro‑décisions. Au lieu de traiter chaque page isolément, le logiciel voit une séquence, aidant à stabiliser le téléphone et à avancer. Cette conception épouse la réalité du papier en clinique et au labo : groupé, urgent, rarement commode. Dès que la capture est continue, on dépense moins d’énergie sur la mécanique et plus sur la vérification et le classement. L’impact sur le flux ne tient pas qu’à la vitesse ; il améliore la gestion des interruptions. En clinique, moins de tapotements, c’est moins de pages manquées quand un appel ou une question coupe le geste. En administration de la recherche, c’est moins de retard pour clôturer des visites ou déposer des amendements sous délai. Promesse modeste mais réelle : des minutes gagnées, répétées des dizaines de fois, réduisent l’arriéré et renforcent la documentation. Reste que l’automatisation déplace les modes de défaillance. En manuel, on marque une pause pour vérifier ; avec une capture « au bon moment », les erreurs deviennent plus silencieuses. Un recadrage peut rogner une marge ; une « amélioration » peut éclaircir des traces de crayon tout en rendant la page plus nette. Plus les outils sont « utiles », plus ils interprètent l’image. D’où une tension autour de l’intégrité : plus la sortie est propre, moins on voit ce qui a changé. Pour les pièces à forts enjeux, il faut conserver une version « telle que capturée » ou, a minima, un protocole clair définissant quand l’amélioration est acceptable. La commodité ne doit pas réécrire la provenance. Éthiquement, la numérisation médiée par l’IA exige une transparence qui nous incombe. Même si le logiciel décide du déclenchement, du recadrage ou de l’amélioration, la responsabilité nous revient si l’enregistrement est incomplet, trompeur ou décontextualisé. Le minimum éthique : clarté et maîtrise, savoir quand l’automatisation intervient, auditer rapidement, et refaire ou conserver une version minimalement traitée quand la précision prime. L’intégrité des données concerne aussi l’automatisation bien intentionnée qui efface des détails significatifs. À l’avenir, on verra davantage d’« IA du quotidien » : discrète, intégrée, orientée workflow. Pour chercheurs, cliniciens et doctorants, l’enjeu est d’allier vitesse et gouvernance : nommage cohérent, arborescences sensées, contrôles ponctuels, règles claires de stockage et de partage. Si l’on traite la numérisation automatique comme un outil de documentation vérifiable, responsable et traçable, le tournant sera bénéfique. Le papier ne disparaîtra pas, mais il cessera peut‑être de capter une attention disproportionnée au détriment du travail qui requiert vraiment notre présence.

French

« AI Blueprint » de la Maison-Blanche : une architecture ambitieuse, mais encore incomplète

Le cadre national de politique publique sur l’IA de la Maison-Blanche, publié le 20 mars 2026 (il n’a qu’une semaine d’existence au 29 mars 2026), se lit comme un plan d’orientation législative plutôt que comme un règlement abouti. Il vise à poser les termes du débat — ce que le Congrès devrait encadrer, ce qu’il devrait éviter, et quels risques traiter en priorité. Pour les praticiens et les chercheurs, l’enjeu central est de savoir si ce plan directeur se traduira en protections opérationnelles ou s’il restera au stade du signal politique. Sur le plan « explicatif », le document regroupe ses pistes en sept blocs : protection de l’enfance, protection des communautés, droit d’auteur, liberté d’expression, innovation, formation de la main‑d’œuvre et préemption fédérale. Cette architecture éclaire les priorités que l’exécutif entend soumettre au Congrès. Elle trahit toutefois un arbitrage classique : privilégier l’ampleur sur la profondeur, avec des sections qui indiquent une direction sans toujours préciser normes, seuils ni modalités d’application. L’affirmation structurelle la plus nette concerne la préemption fédérale, l’idée que les règles d’IA devraient relever d’un cadre national plutôt que d’un patchwork État par État. Sur le papier, une norme unique réduit la complexité de conformité et facilite les déploiements inter‑États. Dans les faits, la préemption n’est jamais neutre : elle conditionne la capacité des États à servir de laboratoires de protection plus exigeants… ou, au contraire, à voir leurs garde‑fous balayés avant maturité. S’agissant de la protection des enfants et des communautés, l’intuition du cadre épouse une approche fondée sur les risques : prioriser les publics les plus vulnérables et les préjudices les plus diffusables. Mais « protéger les enfants » peut masquer des choix de conception âpres : vérification de l’âge, minimisation des données, réglages sûrs par défaut, audits substantiels. Sans exigences concrètes, ce qui doit être testé, journalisé et vérifié de manière indépendante, le langage reste programmatique tandis que des systèmes potentiellement nocifs demeurent déployables. La section droit d’auteur illustre au plus près le biais « innovation d’abord » du cadre, en penchant vers une permissivité autour de l’entraînement et en renvoyant aux tribunaux le soin de trancher l’essentiel des litiges. Cela lisse les frictions pour les développeurs de modèles, mais déporte l’incertitude vers l’aval, côté acheteurs et opérateurs, universités, hôpitaux, startups. Quand la provenance est floue, on finit par normaliser le « faites‑nous confiance », socle fragile pour la légitimité publique et la reproductibilité. Le cadrage de la liberté d’expression envoie des signaux utiles, mais il peut estomper une ligne décisive : protéger l’expression n’équivaut pas à exonérer l’amplification, le ciblage, la fraude ou la tromperie à fort impact. Si le débat se réduit à « régulation versus liberté d’expression », on perd en précision sur l’objet réel de la régulation : les dommages mesurables, les schémas de conception manipulateurs, les déploiements négligents en contextes sensibles. Un cadre peut défendre les droits tout en exigeant des garanties de sécurité auditées pour les systèmes puissants. Là où la seconde moitié du cadre, et la « plongée approfondie » qui l’accompagne, demeure floue, c’est sur l’ossature opérationnelle manquante. Il faut des définitions nettes (qu’est‑ce qu’un système à haut risque), des obligations explicites (quels tests pré‑déploiement), et une gouvernance robuste (déclaration d’incidents, standards de red teaming, audits indépendants, suivi post‑déploiement). Les bacs à sable ne sauraient tenir lieu de protections de base : sans règles d’arrêt et supervision externe, ils deviennent des voies rapides vers le marché, pas des voies plus sûres vers l’évaluation. Enfin, le texte sous‑appréhende la réalité clinique et de la recherche : la confidentialité n’est pas un appendice, l’évaluation n’est pas optionnelle, et « l’intégration aux workflows » est précisément l’endroit où la sécurité tient… ou s’effondre. Si la préemption affaiblit la pression des États sans la compenser par des normes fédérales exécutoires, on ouvre un vide où les fournisseurs fixent la barre et où les institutions absorbent, en silence, le risque. Le cadre gagne en crédibilité lorsqu’il convertit des valeurs en exigences : ce qu’il faut tester, documenter, divulguer et surveiller. C’est la seule manière de transformer une ambition nationale en pratiques vérifiables.

French

Utiliser ChatGPT avec Excel lorsque la précision est déterminante

Dans les contextes cliniques et de recherche, Excel reste omniprésent parce qu’il permet de travailler rapidement, simplement et de manière souple. Les journaux de sélection, les suivis d’événements indésirables, les synthèses d’activité clinique ou les bases de données d’amélioration de la qualité commencent souvent et demeurent parfois durablement sous forme de feuilles de calcul. Ce qui devient particulièrement intéressant aujourd’hui, c’est la possibilité de travailler non plus uniquement par formules ou par manipulation directe, mais par le langage. Décrire ce que l’on souhaite faire, puis laisser un système d’IA construire, mettre à jour, analyser ou dépanner un classeur, tout en conservant l’essentiel de sa structure, peut transformer un grand nombre de micro-tâches répétitives. Pour une équipe clinique ou de recherche déjà fortement sollicitée par la documentation et les échéances de reporting, ce changement est loin d’être marginal. L’intérêt ne réside pas tant dans une automatisation abstraite que dans la réduction de tâches fragiles et chronophages : étendre une logique à plusieurs feuilles, réparer une référence après insertion de colonnes, harmoniser des formats de date, ou produire des synthèses cohérentes sous contrainte de temps. L’interaction en langage naturel peut alors agir comme une couche de spécification au-dessus des formules. Par exemple : « Ajouter un indicateur de rendez-vous manqué selon notre définition actuelle » ou « Étendre ce tableau au nouveau site sans modifier le format du rapport ». Lorsqu’elle fonctionne correctement, cette approche permet de recentrer l’attention sur les choix de conception plutôt que sur la mécanique des cellules. La préservation de la structure est ici fondamentale. Dans de nombreux classeurs réels, la logique ne réside pas seulement dans les données, mais également dans la forme même du fichier : conventions de couleur, cellules protégées, formules traduisant des définitions locales, onglets masqués servant au calcul, dépendances entre feuilles. Un assistant d’IA qui reconstruit les tableaux, aplatit les formules ou réorganise librement les colonnes peut compromettre des usages en aval, même si la sortie semble pertinente. La question n’est donc pas seulement : « Le résultat est-il juste ? », mais aussi : « La feuille reste-t-elle fonctionnelle comme système ? » Les usages les plus sûrs se situent souvent du côté de l’ajout ou de la mise à jour contrôlée : création de nouvelles colonnes calculées, mise en place de règles de validation, ajout d’un onglet de synthèse, production d’un tableau croisé ou d’un graphique simple. Ces opérations sont d’autant plus sécurisées lorsqu’on demande explicitement que les modifications soient réalisées dans une zone séparée, un nouvel onglet ou une section clairement identifiée. L’objectif n’est pas de masquer le travail, mais au contraire de le rendre plus facilement relisible et vérifiable. La détection d’erreurs, en revanche, constitue un domaine dans lequel les bénéfices et les risques progressent de concert. Les erreurs de feuille de calcul sont souvent silencieuses : référence absolue devenue relative, plage SUMIF tronquée, conversion texte-vers-nombre produisant des zéros, recherche défaillante après changement de format d’identifiant. Un système d’IA peut aider à formuler des hypothèses plausibles et proposer des corrections minimales, ce qui est précieux lorsque le temps manque. Mais en contexte clinique, une seule cellule modifiée peut suffire à fausser des dénominateurs, des critères d’inclusion ou des valeurs de référence. Un autre apport intéressant concerne la lisibilité au sein d’équipes pluridisciplinaires. Tout le monde ne lit pas aisément des formules imbriquées, et cet écart peut concentrer la compréhension du système entre les mains d’une seule personne. Si un assistant peut traduire une demande telle que « Résumer les taux d’absence par site et par mois, en explicitant le traitement des données manquantes » en étapes explicites et en sorties clairement étiquetées, la feuille devient plus accessible au collectif. Cela peut améliorer la revue par les pairs et réduire les choix analytiques implicites dissimulés dans les cellules. Il subsiste néanmoins des limites qu’aucune interface ne peut abolir. Le langage naturel est ambigu, alors que les feuilles de calcul sont littérales. Une instruction comme « nettoyer les données » peut recouvrir des opérations très différentes : supprimer des espaces, fusionner des catégories, exclure certaines lignes, recoder des valeurs. Les formules générées peuvent paraître convaincantes tout en étant subtilement erronées, et les synthèses produites peuvent ignorer des artefacts comme les doublons, les décalages temporels ou les changements de pratiques de codage. Pour cette raison, l’usage responsable demeure d’abord procédural : gestion de versions, contrôles avant/après, tests sur des cas connus, rapprochement des totaux, et séparation stricte entre données sources, transformations et rapports. Sur le plan éthique, les enjeux majeurs sont la confidentialité, la transparence et la responsabilité. Envoyer des données identifiantes de patients à un outil externe sans cadre de gouvernance approprié serait incompatible avec une pratique rigoureuse. Même dans des environnements sécurisés, il doit être possible de documenter où l’IA a été utilisée, ce qui a été modifié et qui a validé la version finale. En pratique, il est sans doute plus juste de considérer l’assistance par IA comme un collaborateur junior : très utile pour esquisser des transformations, expliquer la logique d’une formule ou proposer des contrôles, mais jamais comme un substitut au jugement méthodologique. Plus le classeur porte des enjeux élevés, décision clinique, reporting réglementaire, résultats publiables, plus les exigences de validation doivent être fortes. À terme, le changement le plus important pourrait être culturel. Le langage naturel nous conduit à expliciter nos définitions avant de les encoder : qu’appelle-t-on un rendez-vous manqué ? Quelle date sert d’ancrage ? Comment traitons-nous les valeurs manquantes ? Si cette explicitation s’accompagne d’une vérification rigoureuse, nous pouvons espérer produire des feuilles non seulement plus rapides à maintenir, mais également plus faciles à auditer, à transmettre et à fiabiliser.

French

Quand les preuves rencontrent l’interface : Wiley–OpenEvidence et la prochaine étape de l’accès aux connaissances cliniques

En clinique, la question qui nous arrête n’est presque jamais celle du « manuel ». Il s’agit bien davantage du patient singulier devant nous, d’une interaction médicamenteuse plausible mais non évidente, de la nuance d’une recommandation récemment actualisée, ou encore d’une analyse de sous-groupe dont nous conservons un souvenir partiel sans pouvoir la citer avec précision. Dans ce contexte, l’annonce, le 3 mars 2026, d’un partenariat entre Wiley et OpenEvidence relève moins d’une actualité technologique que d’une évolution concrète du flux de travail clinique : un grand éditeur concède sous licence un corpus médical de grande ampleur à un système d’IA au point de soin, conçu pour retrouver, synthétiser et citer des preuves biomédicales dans des situations où le temps est compté. Ce qui mérite d’être souligné, ce n’est pas simplement que l’intelligence artificielle poursuit son intégration dans le champ medical, les outils de recherche clinique et d’aide à la décision existent depuis longtemps, mais plutôt que cet accord remet au centre une évidence bien connue : la qualité d’une réponse dépend directement de la qualité et de l’intégrité de la littérature sous-jacente. Wiley formule d’ailleurs le problème de manière particulièrement parlante pour les cliniciens : le volume de publications augmente, tandis que le décalage entre production scientifique et appropriation dans la pratique persiste. OpenEvidence, de son côté, met en avant des réponses fondées sur des preuves, avec la volonté explicite de maintenir le clinicien au contact de sources citables plutôt que de synthèses impossibles à auditer. Le périmètre annoncé est particulièrement significatif. Il inclut notamment des contenus Cochrane, comme la Cochrane Database of Systematic Reviews et les Cochrane Clinical Answers, ainsi que des centaines de revues à comité de lecture publiées par Wiley, sans oublier un ensemble substantiel d’ouvrages et de revues couvrant de nombreuses spécialités. En pratique, cela est important, car les revues systématiques et les réponses cliniques structurées se situent au plus près de ce que l’on pourrait qualifier de niveau « actionnable » de la pratique fondée sur les preuves : celui où les étudiants, internes et cliniciens ont besoin d’une synthèse exploitable sans perdre le lien avec la méthode et les références. Le partenariat met également en lumière une contrainte souvent mal comprise par les utilisateurs finaux : le fait qu’une plateforme puisse analyser le texte intégral d’un article ne signifie pas qu’elle puisse en afficher librement l’intégralité. Dans l’édition scientifique, la version officielle demeure encadrée par le droit d’auteur et par des règles strictes de diffusion. En pratique, cela signifie qu’un outil peut traiter le texte complet en interne tout en ne restituant à l’utilisateur que des citations, des liens et des extraits limités. Ce fonctionnement protège la propriété intellectuelle, mais il crée aussi une tension pédagogique : les cliniciens et les apprenants peuvent avoir le sentiment qu’on leur demande d’accorder leur confiance à un résumé sans accès immédiat au raisonnement, aux méthodes ou aux limites détaillées. Du point de vue du flux de travail clinique, la promesse est claire : gagner du temps sans sacrifier la traçabilité. Si un outil d’IA peut répondre à une question telle que « Quelle est la preuve pour X dans la population Y ? » et orienter immédiatement vers la revue systématique pertinente, l’essai pivot ou l’ouvrage de référence approprié, avec un niveau de contexte suffisant pour juger de l’applicabilité, il peut effectivement réduire une part du temps à faible valeur consacré à la recherche dans plusieurs interfaces. Et ce gain de temps n’est pas anodin : il peut libérer de la disponibilité cognitive pour ce que seul le clinicien peut accomplir, intégrer les comorbidités, les préférences du patient, les contraintes de ressources, la faisabilité et le contexte local. Pour les étudiants en médecine et les internes, il est compréhensible que le premier réflexe soit souvent de se tourner vers des systèmes conversationnels généralistes. Des outils comme ChatGPT, Gemini ou Claude peuvent être utiles pour clarifier un concept, structurer un plan d’étude ou soutenir l’apprentissage. En médecine, toutefois, la fluidité ne doit jamais être confondue avec la fiabilité. Une réponse plausible mais non vérifiable ne constitue pas une simple approximation : elle représente un risque. L’approche la plus rigoureuse consiste donc à réserver les systèmes généralistes à l’apprentissage, à la reformulation ou à la rédaction, et à considérer la recherche de preuves comme une tâche distincte, qui exige des citations, une provenance explicite et la possibilité de vérifier les affirmations à partir des sources primaires. C’est précisément à cet endroit que des plateformes spécialisées peuvent s’avérer plus pertinentes. Non parce qu’elles seraient exemptes de limites, mais parce que leur logique de conception peut être mieux alignée sur les exigences de la pratique fondée sur les preuves. Un système conçu pour répondre à des questions médicales, ancré dans la littérature évaluée par les pairs et capable d’offrir une véritable piste de citations, correspond davantage à la manière dont nous enseignons et pratiquons : poser une question, rechercher, évaluer de manière critique, appliquer, puis réévaluer. Il convient néanmoins de reconnaître les limites de ce type d’intégration. Tout corpus sous licence a des frontières : ce qui est inclus, ce qui ne l’est pas, les spécialités les mieux représentées, les années les plus couvertes, les formats réellement accessibles. Si l’accès le plus robuste d’un système repose principalement sur certains portefeuilles éditoriaux, il existe un risque que la recherche favorise implicitement ces sources, sauf si des mécanismes explicites d’équilibrage sont mis en place. Et bien entendu, la littérature biomédicale elle-même n’est pas exempte de biais : biais de publication, représentativité mondiale inégale, évolution des standards méthodologiques. En d’autres termes, un corpus plus vaste ne garantit pas à lui seul un meilleur jugement clinique. Sur le plan éthique, de tels partenariats renforcent les exigences de transparence, de responsabilité et d’intégrité des données. Il est légitime d’attendre une information claire sur la nature du contenu interrogé, sur la sélection des citations et sur la manière dont l’incertitude est présentée, notamment lorsque les preuves sont faibles, contradictoires ou incomplètes. La question de la

French

Mots originaux, idées réutilisées : la réalité du plagiat dans la recherche générée par IA

Tout ce qui « a l’air » nouveau ne l’est pas vraiment. Les IA génératives peuvent réellement booster la productivité en recherche : plan détaillé, réécriture, traduction, et même remue‑méninges quand on est bloqué. Mais la même aisance qui rend ces sorties « publiables » peut aussi masquer un risque plus discret : des travaux générés par IA peuvent recycler, sans intention malveillante, des connaissances existantes, non pas forcément en copiant des phrases, mais en réutilisant des idées, des ossatures argumentatives familières, des logiques d’étude déjà vues, et une nouveauté de façade. C’est la réalité à laquelle beaucoup de chercheurs sont désormais confrontés : le problème d’intégrité n’est souvent pas un plagiat flagrant, mais une réutilisation cachée, où le texte est original dans la forme, tandis que l’apport intellectuel est mince, dérivé, ou trop proche de l’existant. Dans ces cas‑là, la « nouveauté » devient un effet de surface, et l’intégrité scientifique consiste moins à débusquer du texte copié qu’à protéger la véritable originalité, la traçabilité du raisonnement et l’honnêteté de la contribution. Un exemple éclairant vient de l’étude ACL 2025 de Gupta et Pruthi, All That Glitters is Not Novel: Plagiarism in AI Generated Research (Outstanding Paper à ACL 2025). Leur objet n’est pas le simple copier‑coller, mais une forme plus subtile : des textes de style recherche qui reformulent ou recombinent des travaux antérieurs de manière à paraître « neufs » lors d’une relecture rapide. Au lieu de demander aux évaluateurs de juger la nouveauté comme d’habitude, les auteurs ont conçu un dispositif piloté par des experts, explicitement chargés de rechercher des sources de plagiat. Ils ont fait évaluer 50 documents de recherche générés par LLM (y compris des documents issus de « The AI Scientist » et d’autres propositions publiques, ainsi que de nouvelles générations). C’est important, car les évaluations classiques supposent souvent la bonne foi et n’incitent pas à une chasse active aux sources. Ils ont aussi utilisé une grille claire : les notes les plus élevées correspondaient aux cas où l’on observe quasiment une correspondance un‑pour‑un entre la méthodologie générée et des travaux antérieurs, ou bien où des pans substantiels sont empruntés à un petit nombre d’articles précédents sans attribution. Autrement dit, il ne s’agit pas d’identifier des phrases identiques, mais de constater que l’ossature intellectuelle de la méthode et de la contribution est trop proche de quelque chose qui existe déjà. Le résultat clef est difficile à ignorer : les experts ont signalé 24 % des 50 documents comme plagiés (notes 4–5) après des vérifications comprenant le contact avec les auteurs originaux ; si l’on inclut les cas où la vérification n’a pas été possible (par ex. auteurs injoignables), le taux monte à 36 %. Cet écart compte, car il montre comment les cas « confirmés » peuvent rester sous‑estimés lorsque la vérification réelle est lente ou impossible. C’est précisément ce qui rend le plagiat à l’ère de l’IA si particulier : le risque se loge souvent au niveau des idées, du cadrage du problème, de la chaîne méthodologique et des revendications de contribution, plutôt que dans la phraséologie identique. Si une proposition est rédigée avec assurance, présentée par sections impeccables et saupoudrée de citations plausibles, elle peut passer un contrôle de surface, même si le concept sous‑jacent n’est pas vraiment original. L’étude met aussi en évidence un second problème : l’automatisation ne nous sauve pas (encore). Les auteurs rapportent que plusieurs approches automatisées, notamment la recherche par embeddings et un service commercial de détection de plagiat, se sont révélées insuffisantes pour repérer le plagiat dans ces propositions générées par LLM. C’est cohérent avec une réalité plus large : « l’emprunt sémantique » est bien plus difficile à détecter que le recouvrement de chaînes de caractères. Pour l’évaluation par les pairs, cela crée un compromis pénible en termes de charge de travail. Si l’IA augmente le volume de soumissions très polies tout en accroissant la probabilité d’emprunts cachés, les relecteurs doivent passer davantage de temps en travail d’enquête : fouiller la littérature, cartographier les méthodes, vérifier si les « contributions originales » ne sont pas de simples versions renommées d’idées connues. Cette pression ne fait pas que ralentir la revue ; elle peut aussi pousser les évaluateurs vers des heuristiques superficielles, rendant le système encore plus facile à contourner. Pour les auteurs qui utilisent l’IA de manière éthique, l’état d’esprit le plus sûr est : l’IA peut vous aider à exprimer vos idées, mais elle ne doit pas être la source de votre contribution. Gardez une « trace de provenance » : ce que vous avez lu, ce que vous avez copié dans vos notes (entre guillemets), et ce que vous avez décidé vous‑même. Si l’IA suggère une méthode ou un cadrage, traitez‑les comme des indices non fiables ; puis vérifiez en recherchant les travaux antérieurs et en ajoutant des citations explicites là où votre idée se rattache à la littérature existante. Pour les universités, les revues et les conférences, la réponse ne doit pas être la panique, mais la mise à niveau des processus. Exigez une divulgation transparente de l’usage d’IA, renforcez les contrôles de nouveauté (surtout au niveau des idées/méthodes), et donnez aux relecteurs des outils et du temps pour mener des recherches ciblées de sources quand quelque chose paraît « trop propre ». Surtout, récompensez la citation soignée et le positionnement honnête (« ceci est une extension de X ») plutôt que la sur‑vente de la nouveauté ; car à l’ère de l’IA, il est plus facile de fabriquer une nouveauté apparente que du véritable progrès scientifique. Enfin, c’est précisément là que les relecteurs humains et le jugement humain restent essentiels, et où la responsabilité ne peut pas être externalisée. Parce que la réutilisation au niveau des idées est subtile, il faut souvent une expertise de domaine pour repérer quand une « nouvelle » chaîne de traitement n’est en réalité qu’une version renommée ou légèrement réarrangée d’un travail établi. Autrement dit, l’intégrité à l’ère de l’IA repose moins sur des alertes automatisées que sur

Shopping Cart